SciFusion: Physics-Guided Compositional Diffusion for Multimodal 3D Scientific Image Generation
Abstract
Existing 3D generative approaches are typically developed for individual imaging modalities, requiring substantial modality-specific data and limiting their ability to exploit shared structure across scientific imaging domains. We present SciFusion, a multimodal framework for unified 3D scientific image generation built on a latent diffusion backbone. SciFusion factorizes each modality into domain, object, and contrast representations, enabling knowledge transfer and zero-shot synthesis of unseen compositions. It also incorporates domain-specific physics-informed objectives—Fourier spectral consistency for MRI, Radon projection consistency for CT, and multislice diffraction consistency for electron microscopy. Experiments across 15 medical and scientific imaging modalities show improved generation fidelity and cross-domain generalization over modality-specific and flattened multimodal conditioning strategies.
Method
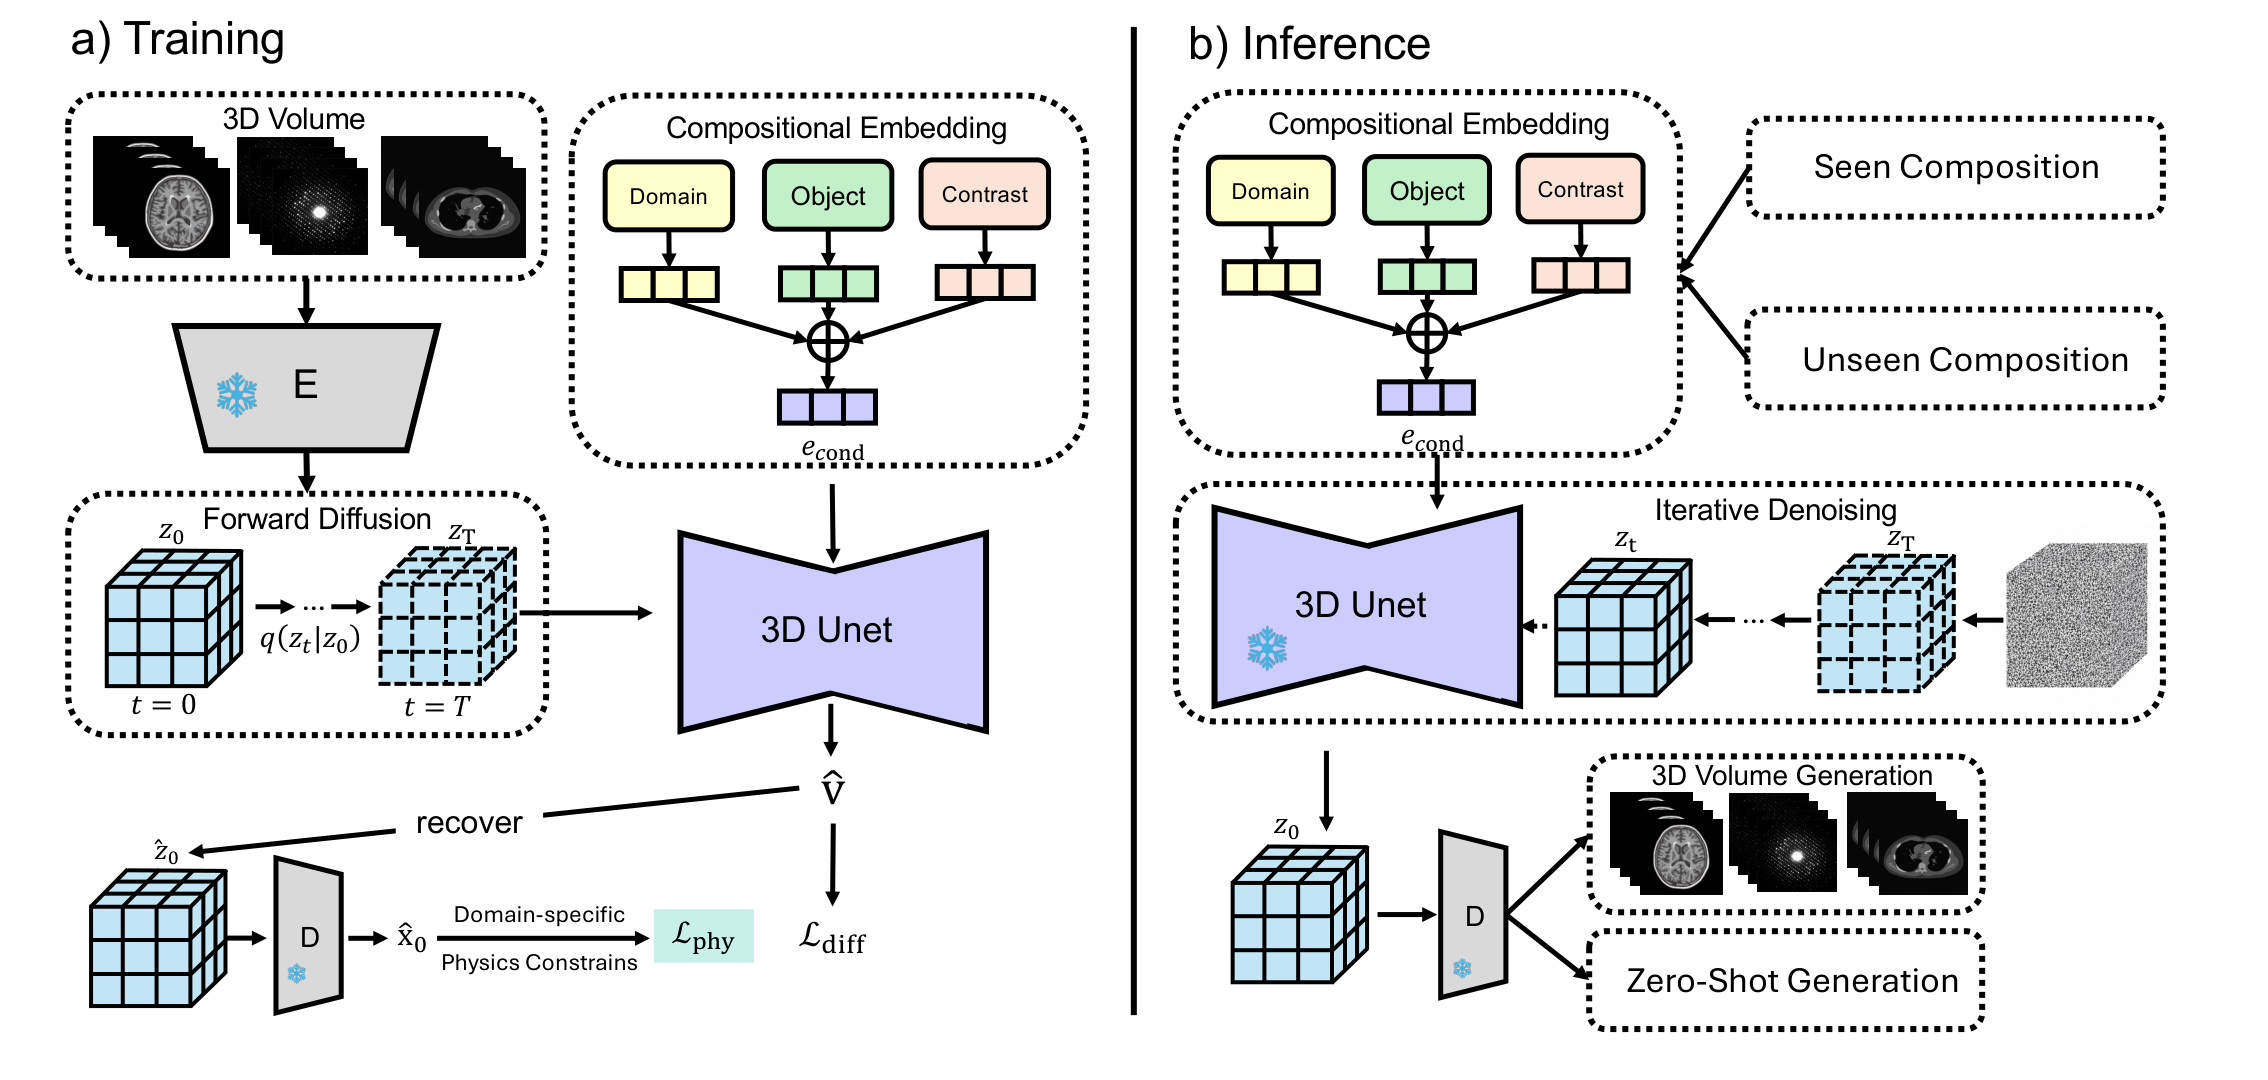
SciFusion combines a shared latent diffusion backbone, compositional domain–object–contrast conditioning, and domain-specific physics guidance. At inference, learned factors can be recombined for seen and unseen compositions.
Experiments
Unified Multimodal Generation
Joint training reduces the number of required models from 15 to 1 while improving generation quality. Compositional conditioning further reduces I3D-FVD from 11.80 to 11.10 and VideoMAE-FVD from 28.63 to 27.30. Adding domain-specific physics guidance gives the best overall result, reaching an I3D-FVD of 9.90, a VideoMAE-FVD of 23.51, and a JEDI score of 1.80.
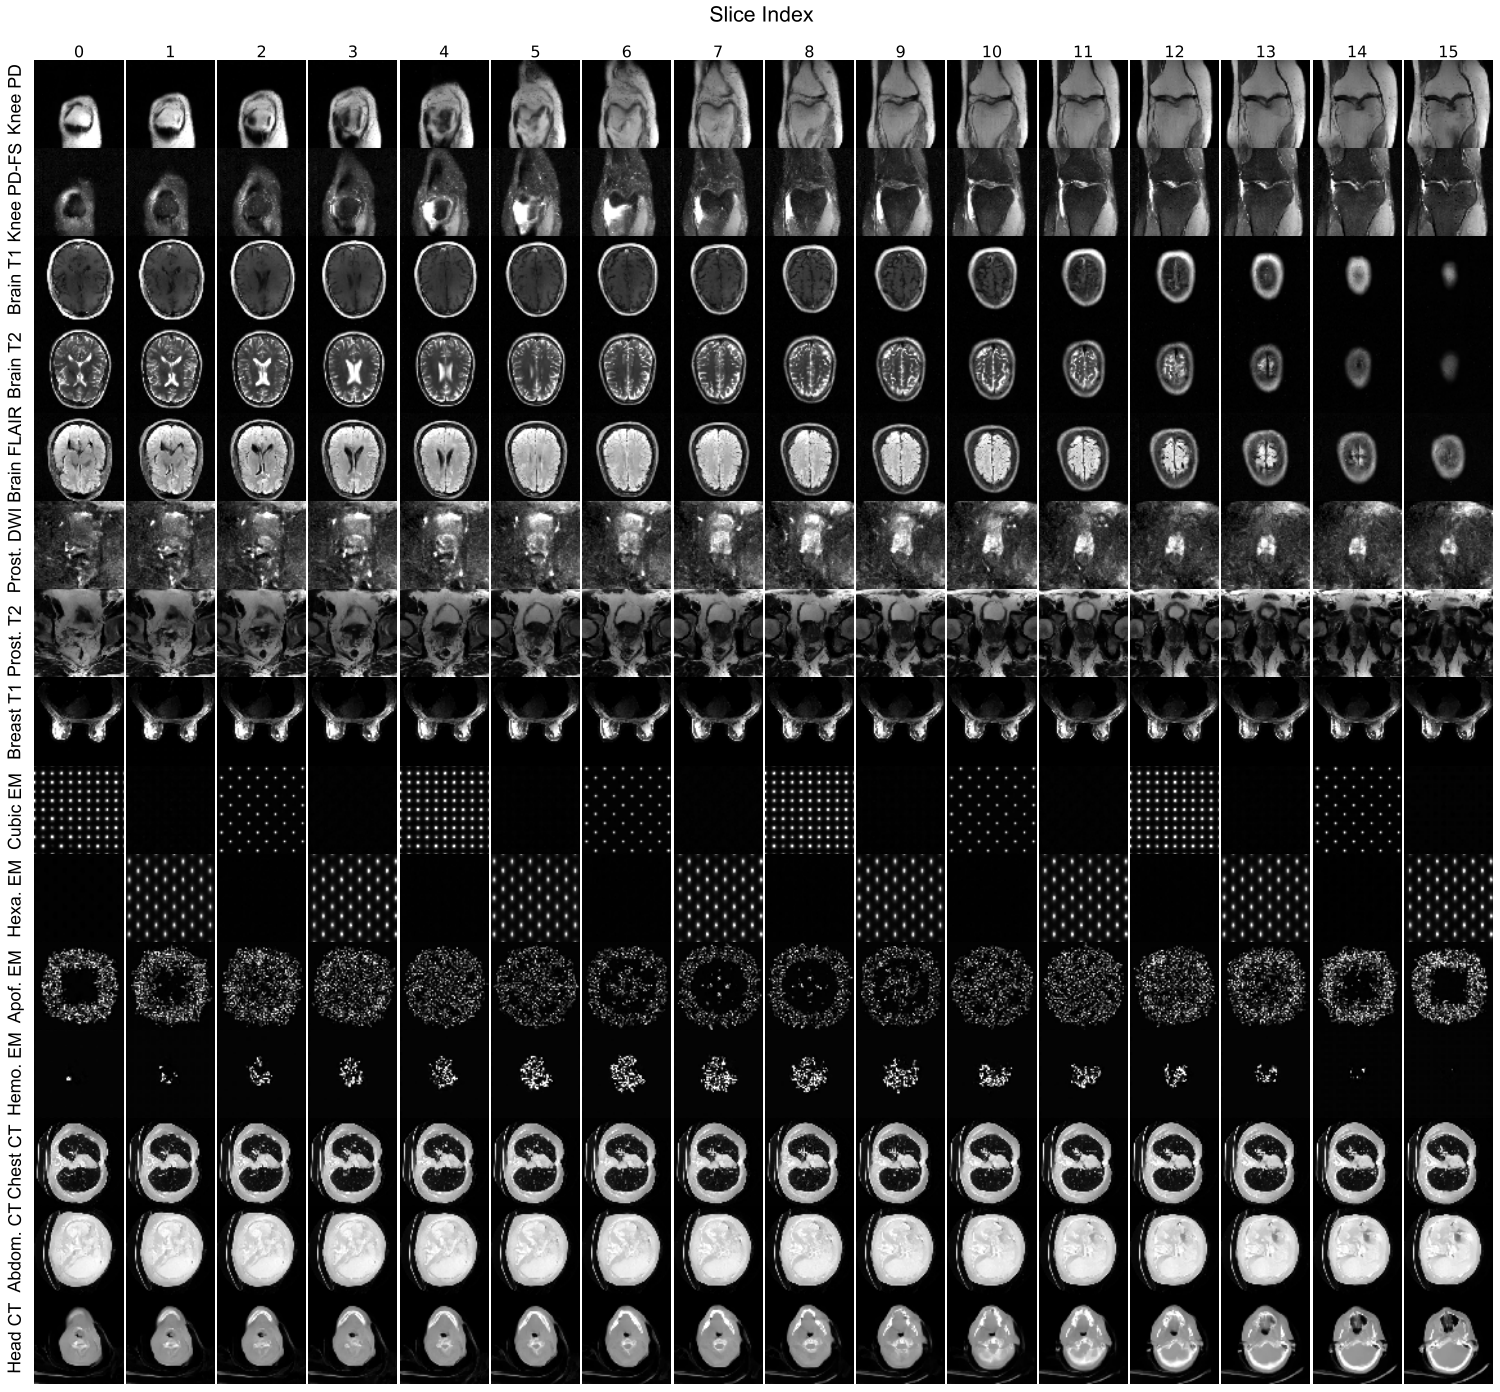
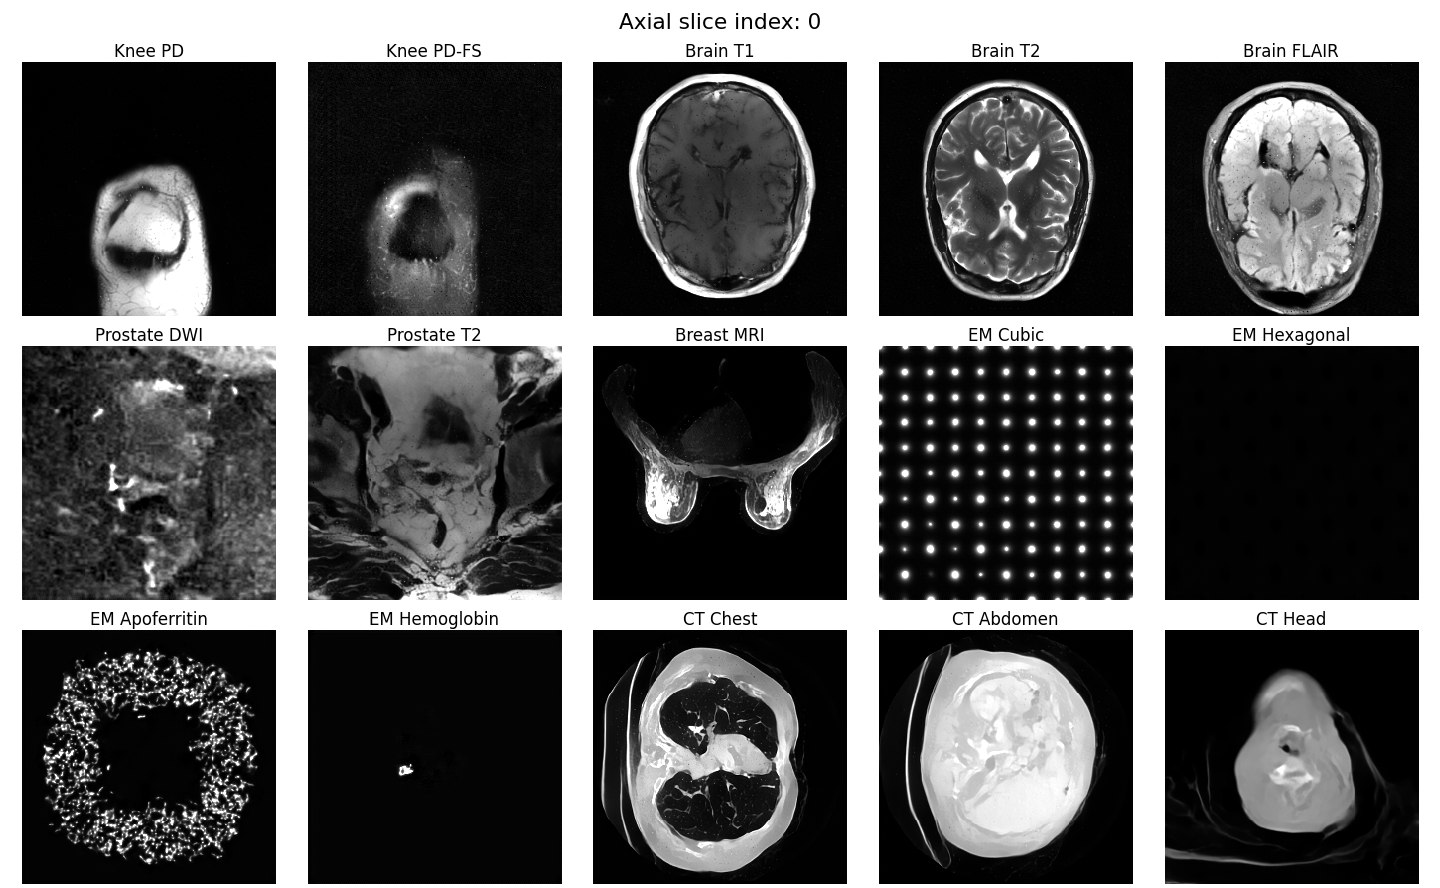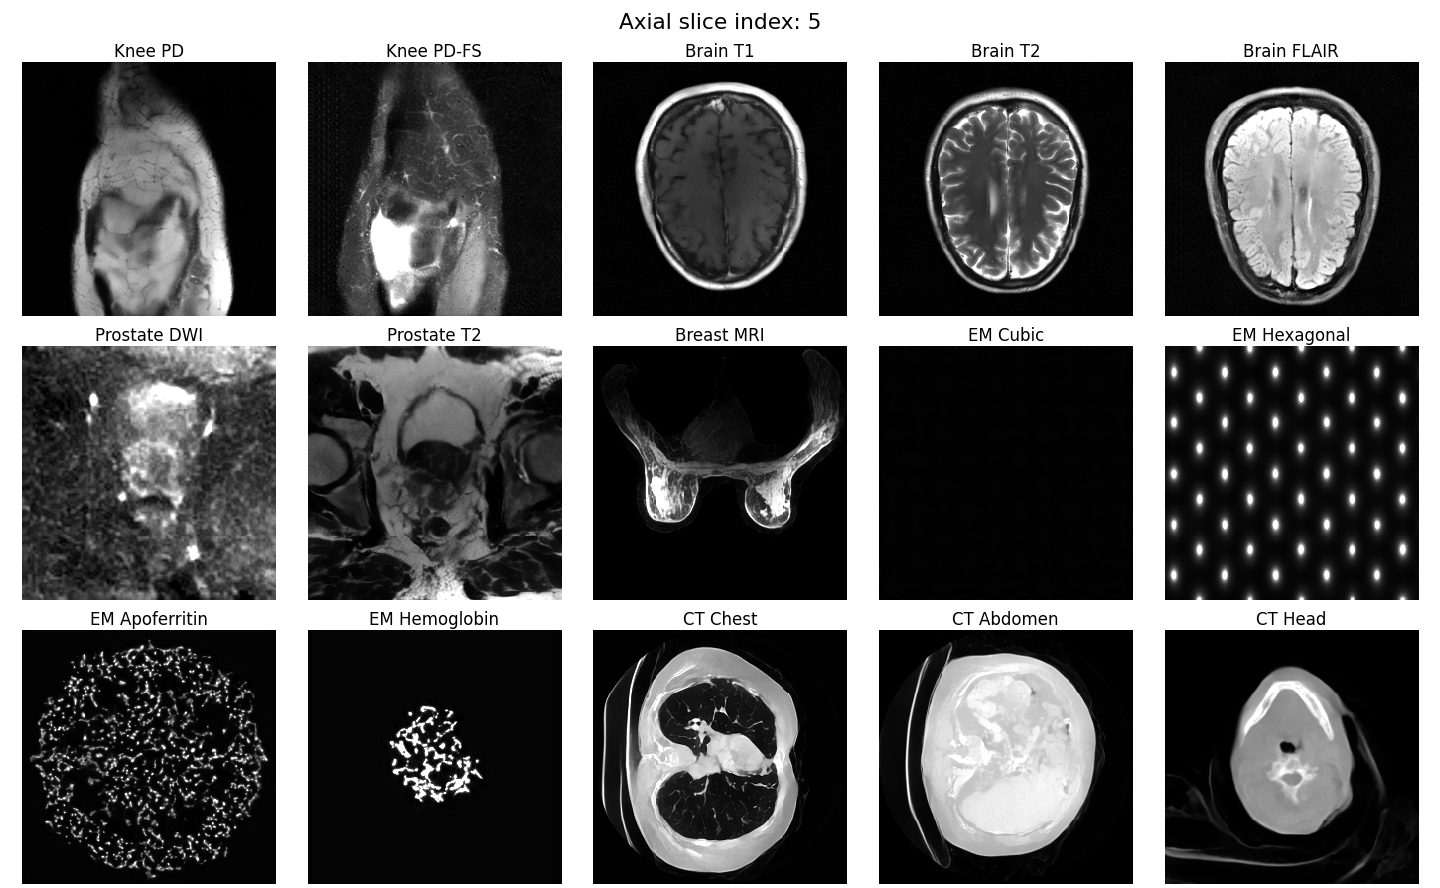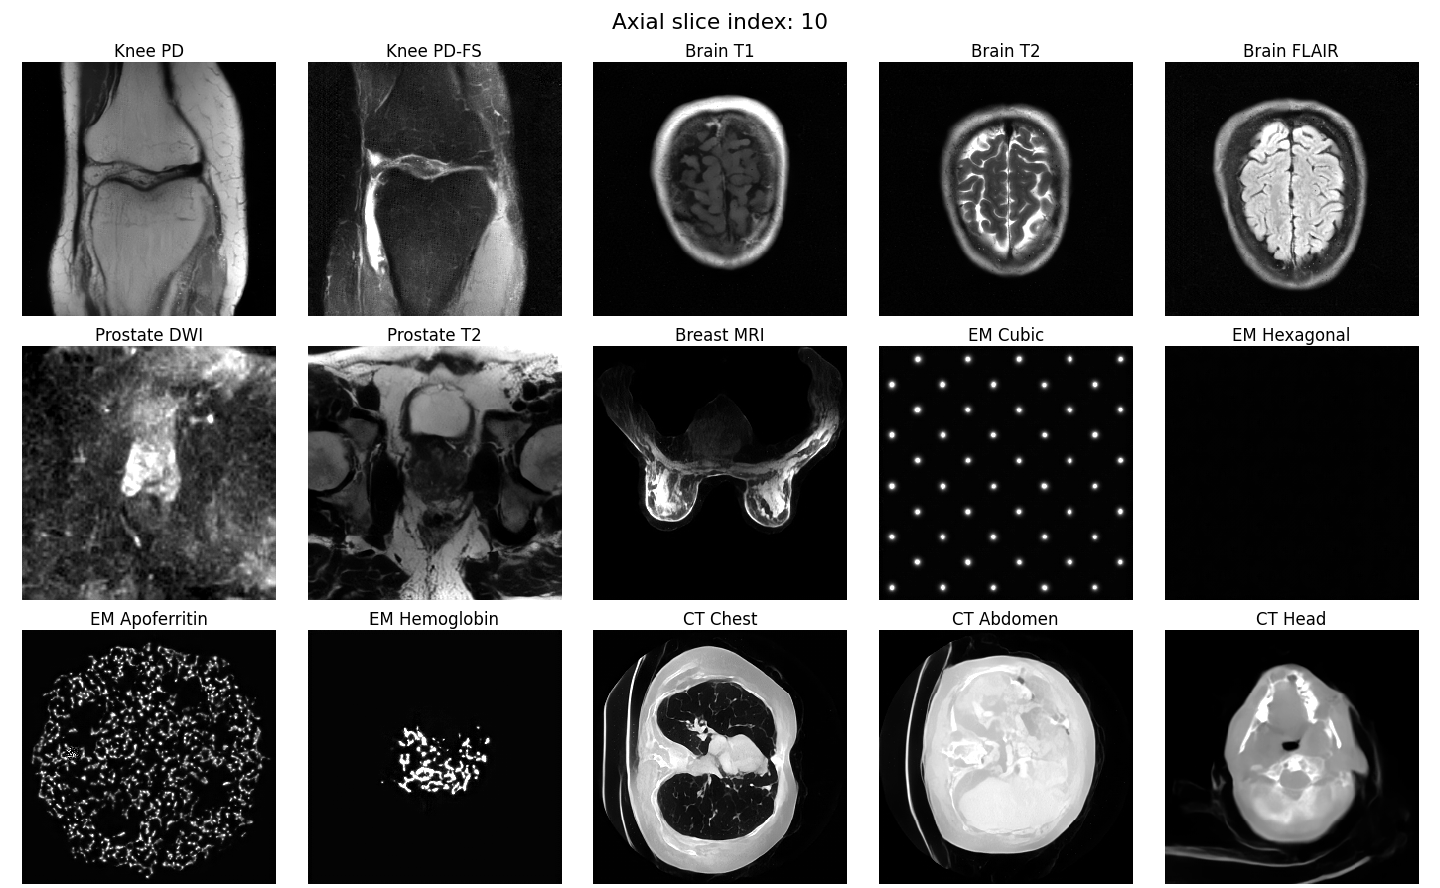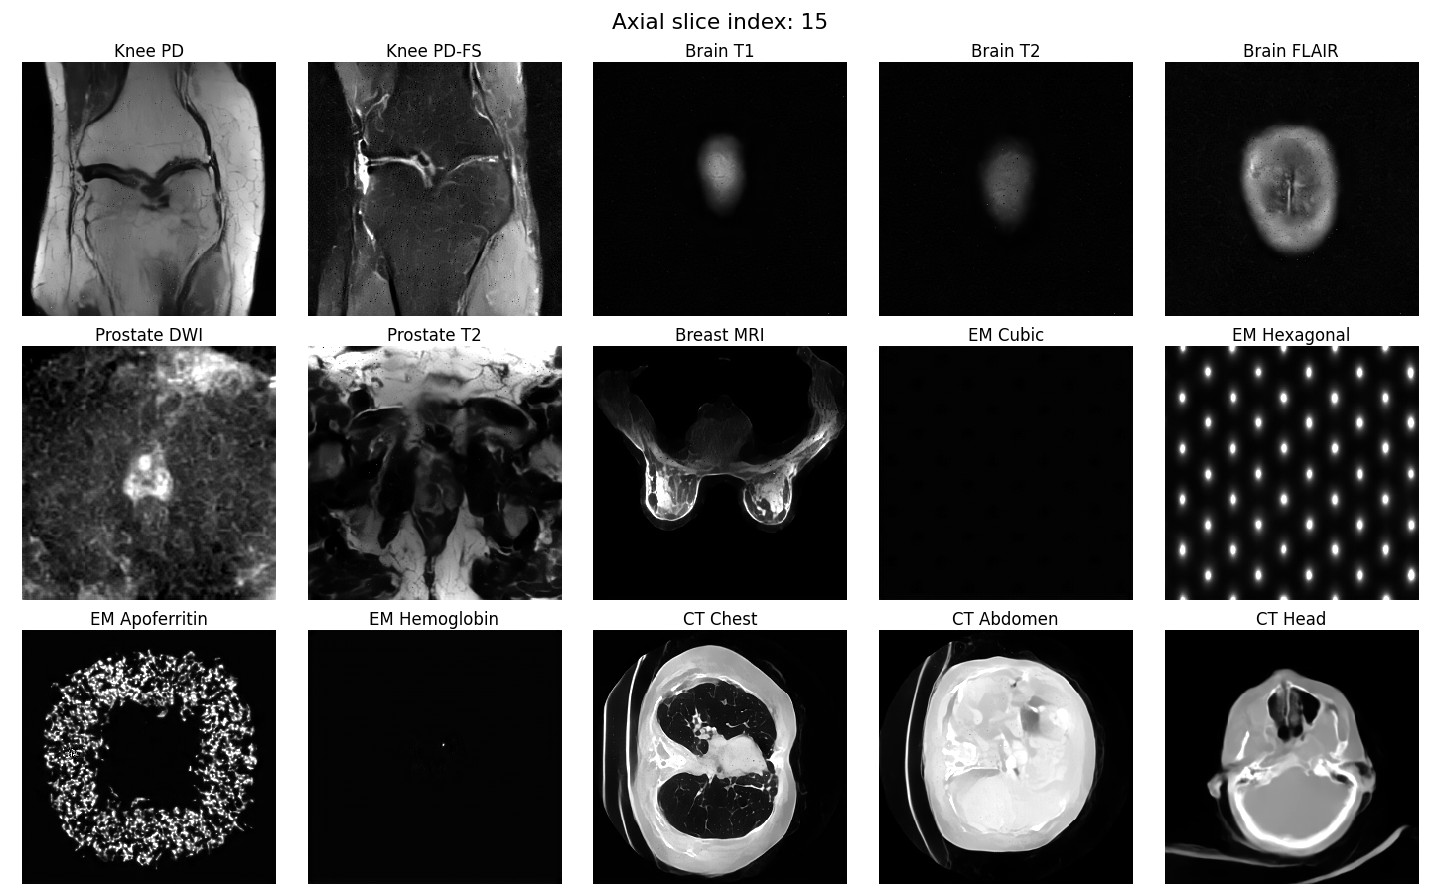
Representative generations across all 15 imaging modalities; each row shows the 16 slices of one generated volume.
| Configuration | # Models | I3D-FVD ↓ | VMAE-FVD ↓ | JEDI ↓ |
|---|---|---|---|---|
| Single Modality | 15 | 13.07 | 35.93 | 2.62 |
| Flat Multimodal | 1 | 11.80 | 28.63 | 2.36 |
| Comp. Multimodal | 1 | 11.10 | 27.30 | 2.35 |
| SciFusion (+ physics) | 1 | 9.90 | 23.51 | 1.80 |
Comparison with Existing Methods
We compare SciFusion with MedLoRD, Video Diffusion, 3DMedDiff, and Medical Diffusion across all 15 imaging modalities. SciFusion achieves the best result on every reported metric, with a VideoMAE-FVD of 23.51, VideoMAE-KID of 84.76, I3D-FVD of 9.90, I3D-KID of 16.59, and JEDI of 1.797. Compositional conditioning also improves most backbone-specific baselines; the largest gain is observed for 3DMedDiff, where VideoMAE-FVD drops from 91.27 to 26.85 and I3D-FVD from 33.40 to 11.01.
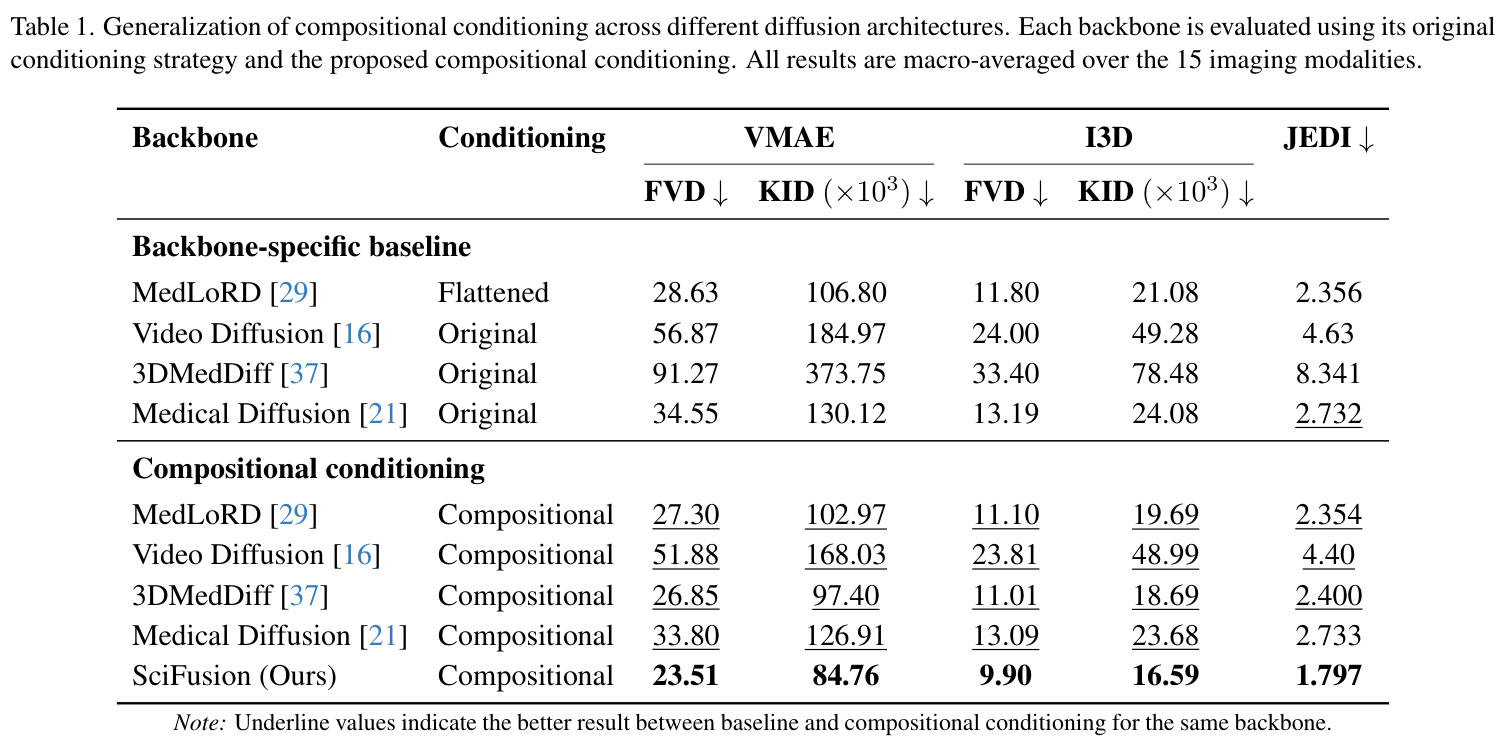
Comparison across diffusion architectures and conditioning strategies. Results are macro-averaged over all 15 modalities; lower is better.
Zero-Shot Compositional Generation
Knee T1 and brain PD are excluded from training as complete modality combinations. SciFusion generates them by recombining learned domain, object, and contrast factors without target-modality samples or additional optimization. Fully supervised models remain the upper bound; however, on brain PD, SciFusion's training-free zero-shot generation matches or exceeds VDM + LoRA on JEDI (1.68 vs. 1.75), even though LoRA uses target-modality samples and additional optimization.
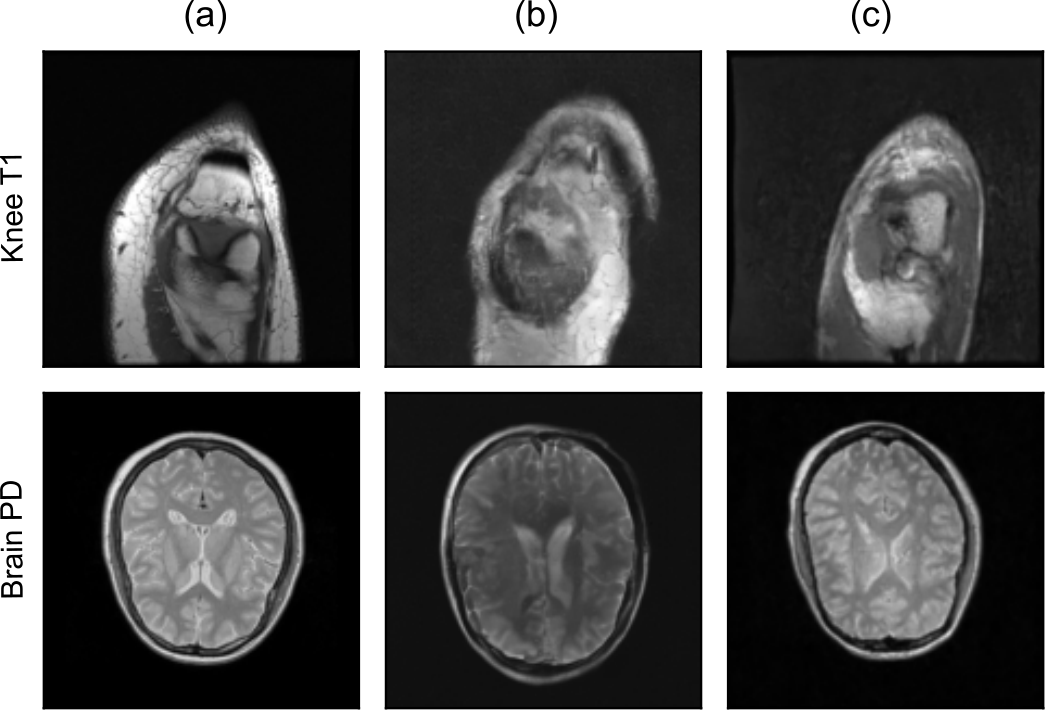
(a) Real target images, (b) SciFusion zero-shot generation, and (c) VDM + LoRA using target-modality samples.
Knee T1
| Method | Supervision | I3D-FVD ↓ | VMAE-FVD ↓ | JEDI ↓ |
|---|---|---|---|---|
| SciFusion | Full | 13.83 | 14.56 | 0.35 |
| SciFusion | Zero-shot | 26.14 | 58.32 | 2.88 |
| Medical Diffusion | Zero-shot | 28.46 | 72.46 | 3.59 |
| VDM + LoRA | PEFT | 15.99 | 25.63 | 1.05 |
Brain PD
| Method | Supervision | I3D-FVD ↓ | VMAE-FVD ↓ | JEDI ↓ |
|---|---|---|---|---|
| SciFusion | Full | 2.90 | 5.22 | 0.46 |
| SciFusion | Zero-shot | 23.52 | 15.34 | 1.68 |
| Medical Diffusion | Zero-shot | 11.02 | 27.97 | 2.25 |
| VDM + LoRA | PEFT | 14.33 | 31.13 | 1.75 |
BibTeX
@misc{wang2026scifusionphysicsguidedcompositionaldiffusion,
  title={SciFusion: Physics-Guided Compositional Diffusion for Multimodal 3D Scientific Image Generation},
  author={Luoxi Wang and Alessio Quercia and Hanno Scharr and Arya Bangun},
  year={2026},
  eprint={2610.30313},
  archivePrefix={arXiv},
  primaryClass={eess.IV},
  url={https://arxiv.org/abs/2610.30313},
}